Chers collègues,
Vous avez mis en place une base de données d’images dans votre structure en ayant conscience que cela permet d’augmenter la traçabilité des données de la recherche en répondant de façon implicite au concept FAIR, soit « Facile à découvrir, Accessible, Interopérable, Réutilisable ». Ce concept est l’un des piliers de la Science Ouverte. La mise en place d'un Plan de Gestion de Données associé à votre structure (PGD de structure) est la formalisation du processus de gestion de vos données décrivant les moyens permettant de les rendre visibles, accessibles, et réutilisables quel que soit le demandeur. Dans le but de vous faciliter la moisson de ces informations, un projet de « PGD structure bioimagerie », porté par et réalisé conjointement avec les Infrastructures Nationales en Biologie Santé (INBS) « France-BioImaging » (FBI), « Institut Français de Bioinformatique » (IFB), et « le Centre National De Ressources Biologiques Marines » (EMBRC-France), ainsi que l'Université Côte d'Azur, est en cours d’élaboration.
Cette initiative à destination des usagers de votre structure facilitera d'une part la communication autour de votre gestion de données, et d'autre part la conception des PGDs projets. En effet, cela permettra à terme que les champs idoines du PGD projet soient automatiquement renseignés par les informations déjà glanées en amont. Par exemple, s'il s'agit du PGD d'un projet émargeant à votre structure, l'utilisateur remplissant son PGD pourra trouver des recommandations et certains champs préremplis pour les données d'imagerie générées au sein de votre structure, et pourra le compléter à terme avec le PGD d'autres structures pour d'autres types de données.
Nous vous proposons de tester et nous donner votre avis sur le questionnaire générique, dédié à l'imagerie, mais pas que, destiné à moissonner ces informations en entrée puis de générer des documents à façon en utilisant des « Templates » ou gabarits d’extraction.
Comment contribuer?
Terminologie
Profils Utilisateurs
Workflow
Partager
Questions-Réponses
Pour participer à la création de ce PGD Structure productrice d'imagerie, deux propositions :
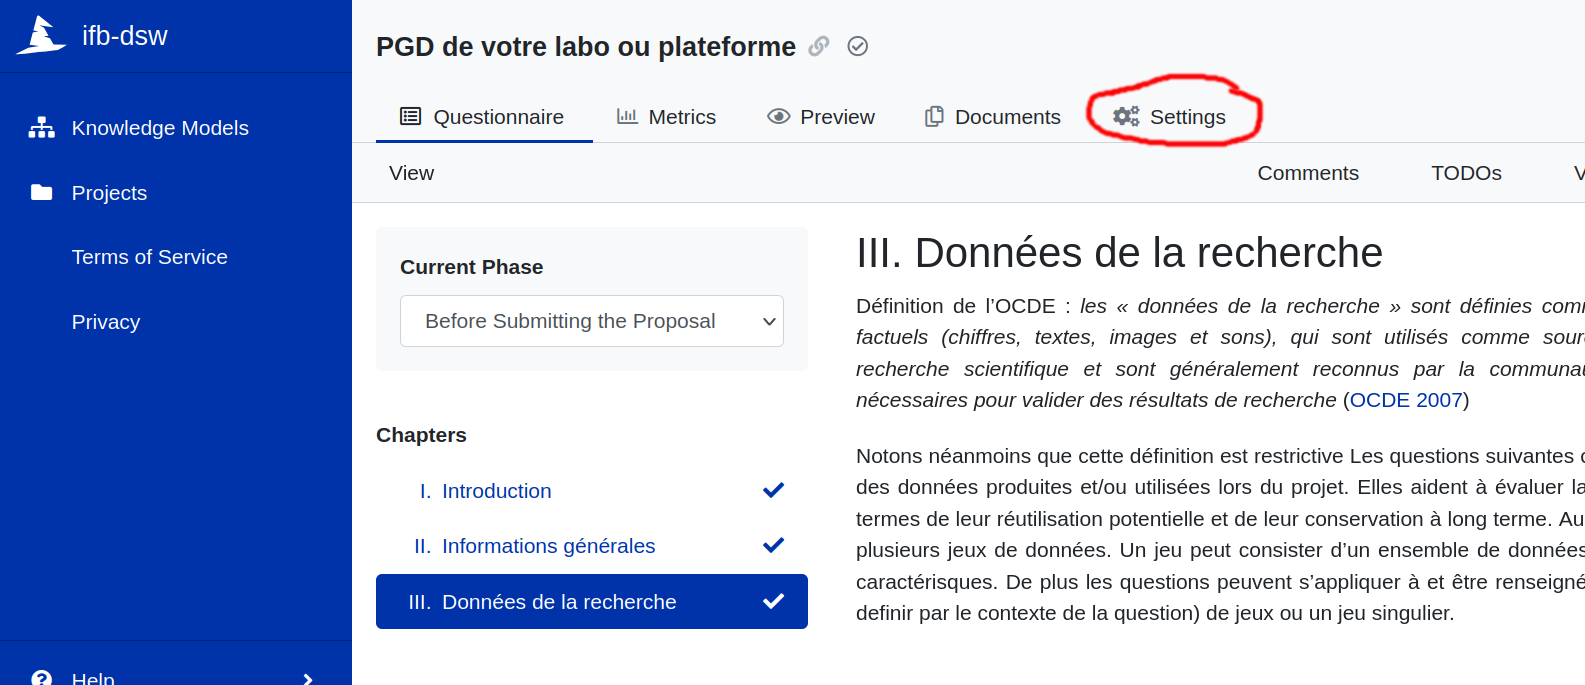
- Vous pouvez consulter sans être identifié un questionnaire non éditable générique, et un exemple pour une plateforme. Notez que vous ne pourrez pas remplir ce questionnaire ni voir les différentes listes d'options disponibles. Vous pourrez faire remonter vos remarques/questions en utilisant la fonctionnalité "Comments" pour soumettre vos questions/problèmes/suggestions d'améliorations. Cette fonction "Comments" est visible à la lecture du questionnaire ainsi :
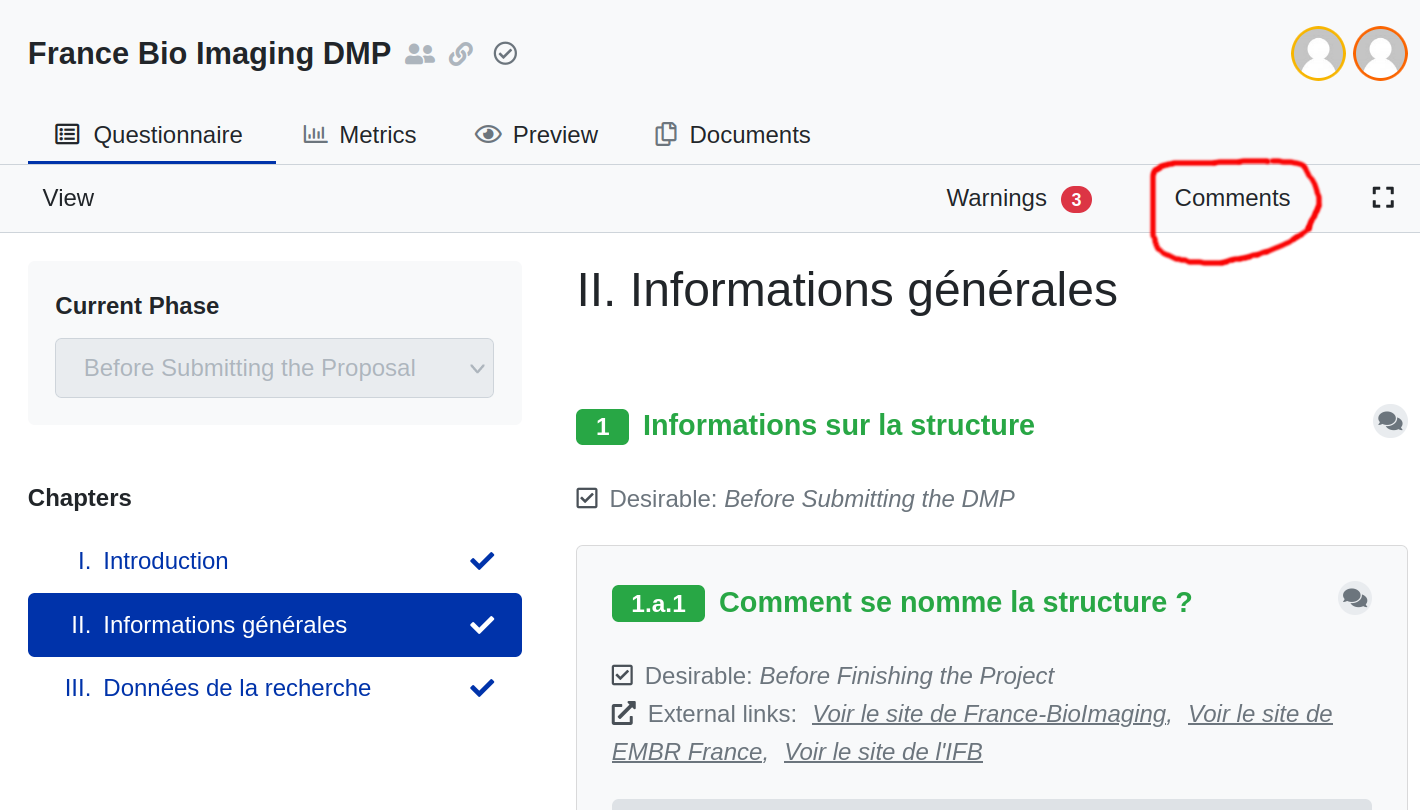
En cliquant sur cet onglet on accède aux fils de discussion et on peut y contribuer. Il est aussi possible de créer un fil de discussion pour chaque question en cliquant sur les bulles qui s'affichent à coté de leur intitulé :
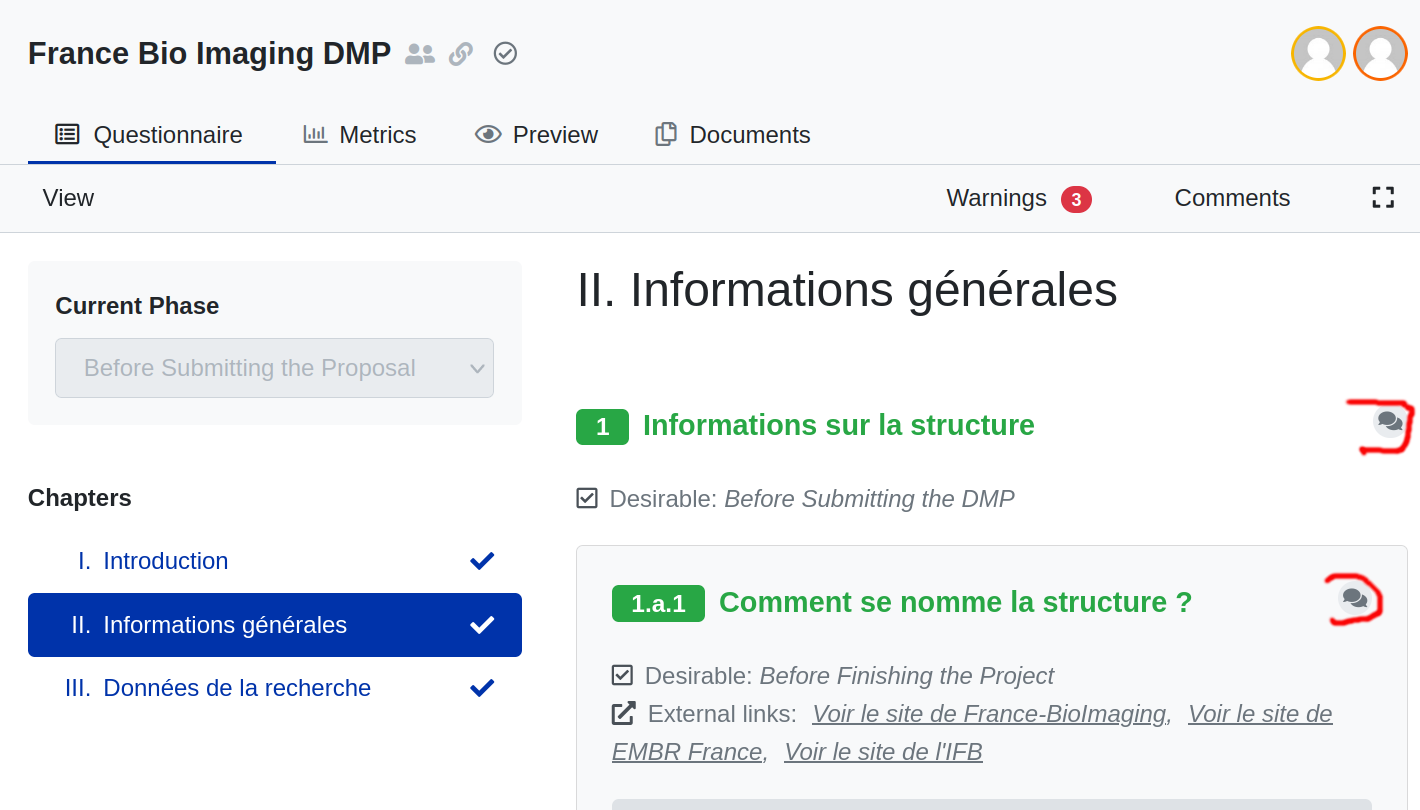
Les fils de discussion montreront l'historique de la conversation ; il est aussi possible de consulter les discussions résolues. Votre nom ne sera pas affiché donc n'hésitez pas à accéder à votre compte pour que les développeurs puisse revenir vers vous si nécessaire.
- Vous pouvez aussi tester l'outil en y apportant les réponses pour votre structure (qui seront privées par défaut sauf si vous décidez de les partager, voir le paragraphe "Partager"). Pour cela nous vous invitons, avec un statut de "Researcher" à suivre le workflow proposé ci-dessous qui vous permettra de créer, de compléter et d'exporter votre propre PGD de structure. Pour pouvoir éditer votre propre questionnaire vierge, il vous faut créer un compte sous l'application Data Stewardship Wizard (DSW). Vous pourrez également utiliser la fonctionnalité de commentaires sur les questions décrites ci-dessus, ou émettre des suggestions générales sur gitlab.
-
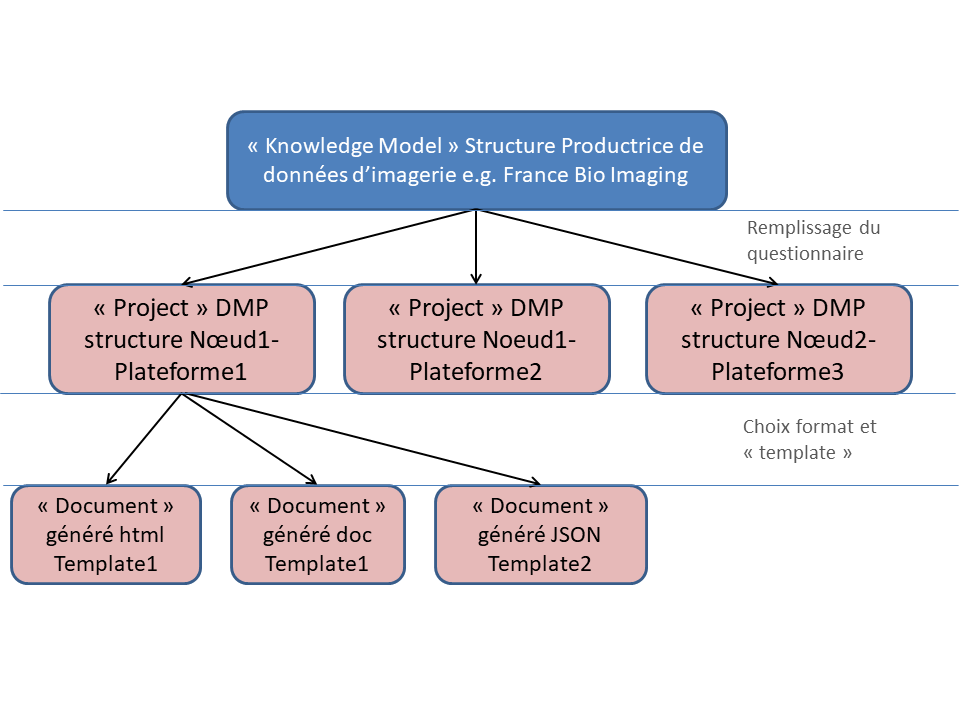
Les « Knowledge Models » (KM) : formats pré-établis de questionnaires vides. Base de connaissances à partir de laquelle un questionnaire est généré. Identifié par un KM ID. Il peut être personnalisé/publié/exporté/importé.
-
Les projets ou questionnaires : représentation d'un KM sous la forme d'un formulaire à remplir.
-
Les (output) templates : gabarits d’extraction ; c'est à dire une mise en forme et une sélection des champs du questionnaire pour en produire un document dans des formats divers (Word, JSON, HTML, ...) qui seront accessibles dans l'onglet "Documents" d'un questionnaire. Ces gabarits sont encore limités mais sont un outil très puissant pour ne pas rentrer plusieurs fois les mêmes informations, en permettant le reformattage sur une mise en forme attendue par différents acteurs (financeurs, gestionnaire de base de données,...). Par exemple, pour les gestionnaires de base de données un des gabarits permettra d’extraire l’ensemble du document complété.
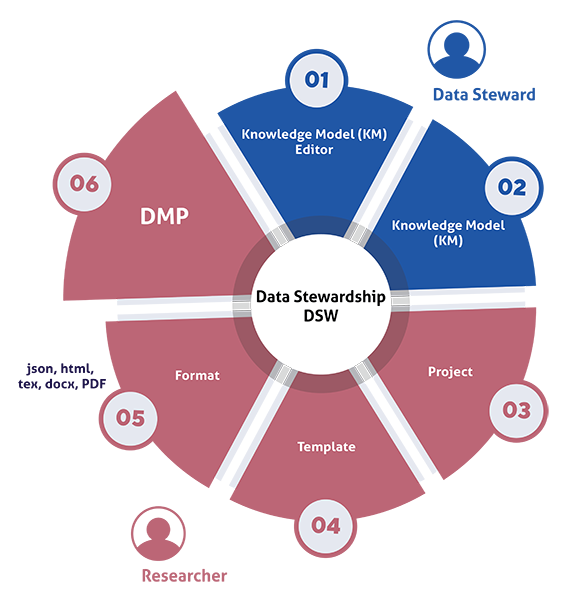
Il existe 4 rôles différents pour un profil utilisateur :
Anonymous : utilisateur de DSW qui n'est pas encore connecté. Elle/il peut s'inscrire, se connecter ou récupérer son mot de passe si oublié.
Researcher : ce rôle est attribué par défaut aux utilisateurs après leur inscription. Nous partons du principe que seuls les administrateurs pourront modifier ces rôles. Cet utilisateur travaille sur un projet scientifique et a les connaissances sur le projet en question. Son objectif est de créer un plan de gestion des données FAIR.
Data Steward : utilisateur qui a la responsabilité de concevoir les modèles de PGD ; elle/il peut créer des « knowledge models ». Ceux-ci sont ensuite utilisés par les scientifiques (ayant le rôle de Researcher) pour créer le PGD avec le questionnaire.
Administrator : elle/il gère les paramètres généraux et dispose des privilèges les plus élevés.
Après avoir obtenu un accès :  , vous pouvez utiliser l’ensemble des fonctionnalités de l’outil DSW :
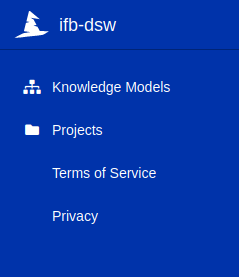
Pour remplir votre propre questionnaire, procédez comme suit :  , puis

ALLER SUR l'ONGLET CUSTOM puis nommez votre projet comme suit "PGD Nom de votre labo ou plateforme" en utilisant le « Knowledge Model » : "PGD structure développé par l'IFB". La dernière version du « Knowledge Model » s'affichera automatiquement :
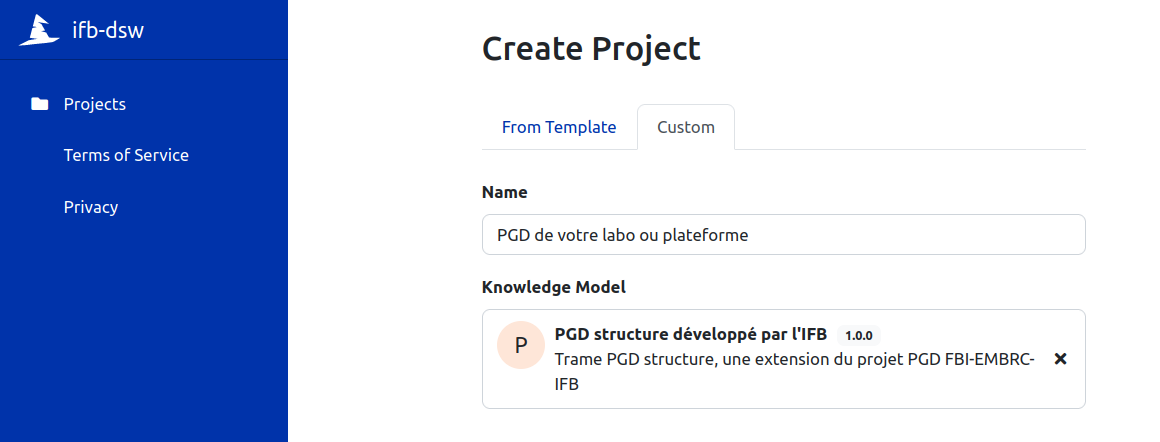
Au 25/08/22 nous en sommes à la version 1.0.0, néanmoins notez que les montées en version vont être nombreuses, dont certaines assez rapprochées, au cours des mois suivants.
Sauvegardez ; votre projet est maintenant disponible dans  . Par défaut, uniquement les projets auxquels vous avez accès seront listés :
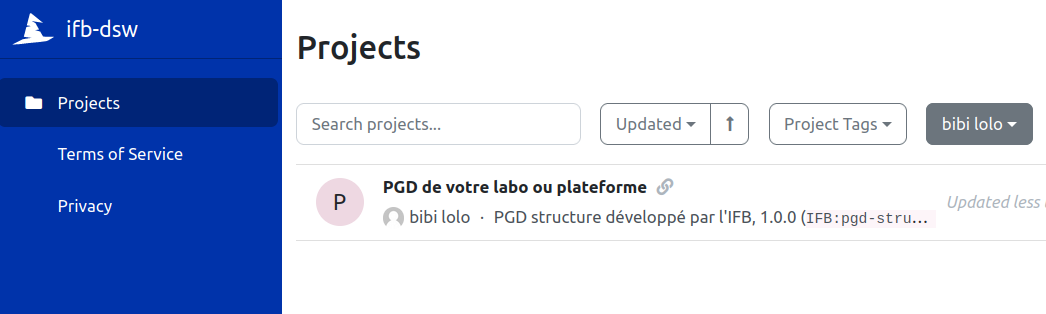
D'abord notons que le remplissage du questionnaire peut-être guidé par la possibilité de naviguer parmi les différentes questions :
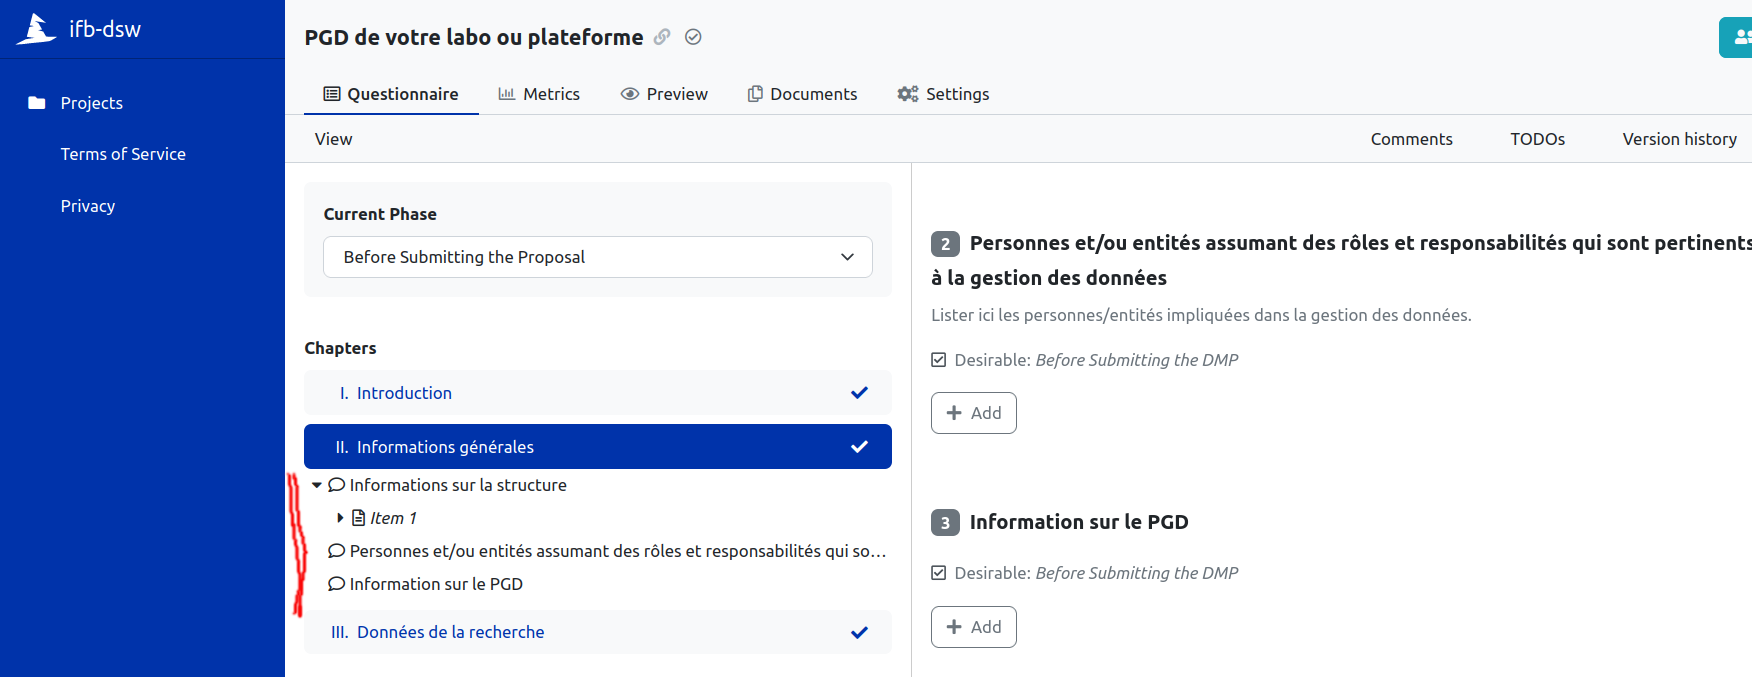
A la création du questionnaire, aucune question n'apparait :
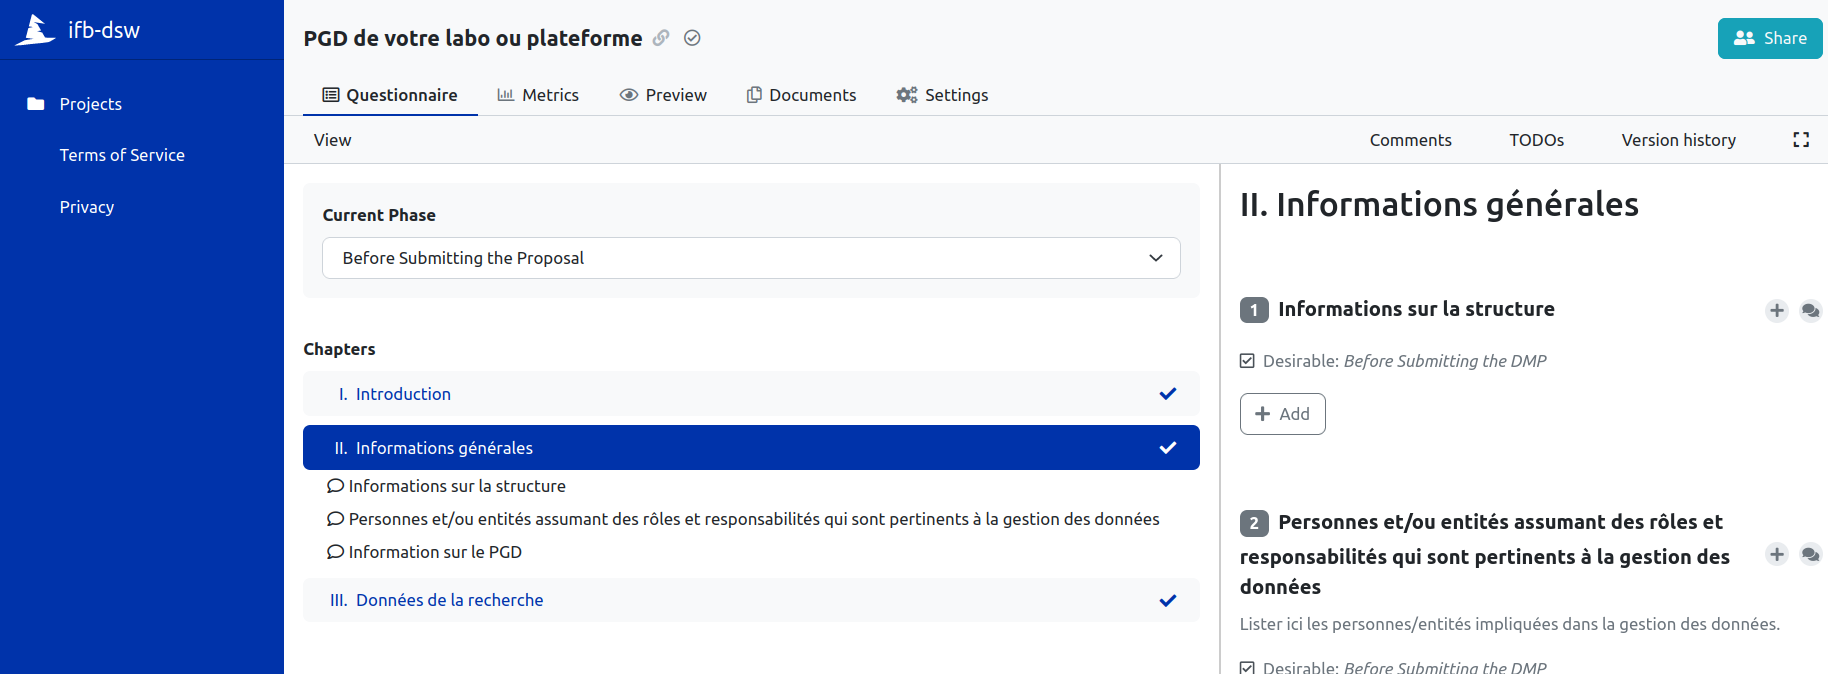
Il va falloir ajouter les questions ("Add"). Typiquement, une seule itération est nécéssaire comme dans le cas d'informations sur la structure (à moins que plusieurs structures soient concernées) :
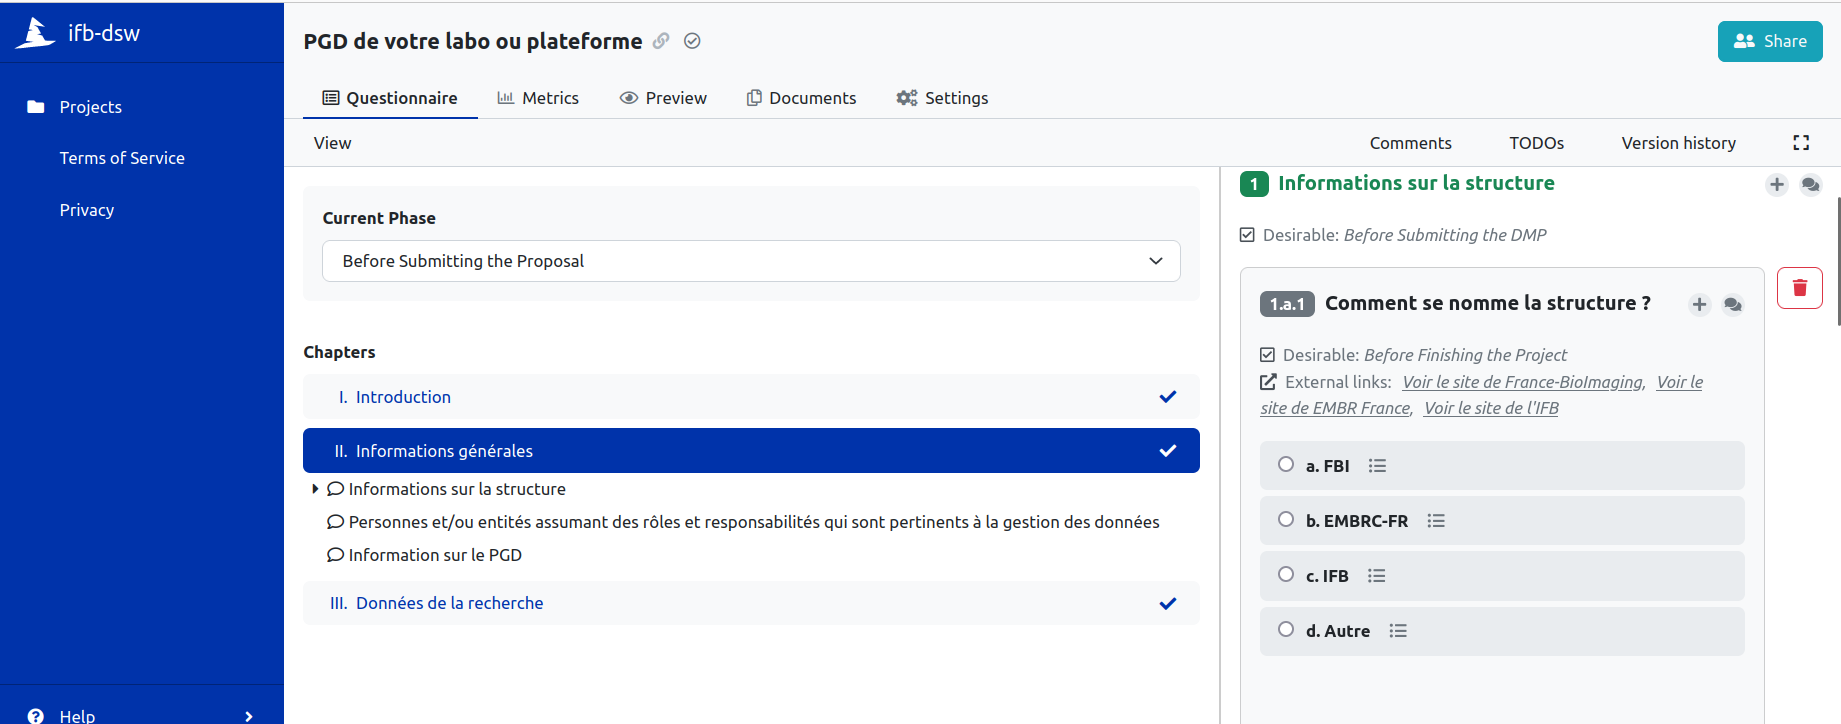
Question Personnes et/ou entités assumant des rôles et responsabilités qui sont pertinents à la gestion des données
Cette question est la suivante dans le chapitre 'Informations générales' :
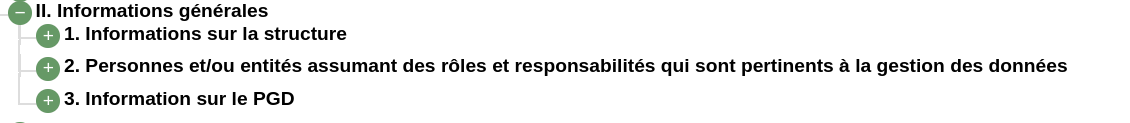
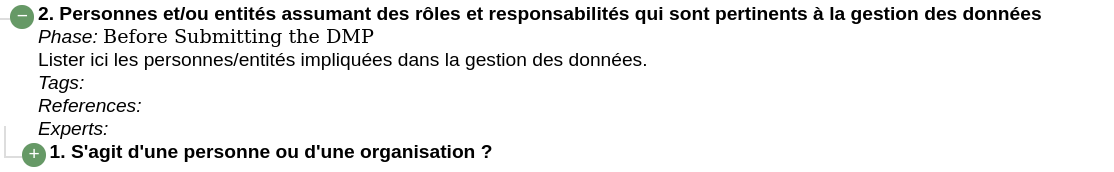
Il est probable que le PGD décrive plusieurs personnes ou entités impliquées dans la gestion des données : la question 'Personnes et/ou entités [...]' a pour objectif de recenser, et décrire, ces contributeurs. Pour chacun d'eux il sera nécessaire d'ajouter un bloc de questions dont l'un des buts est de recueillir le nom du contributeur. Dans la suite du questionnaire les contributeurs et les rôles seront associés par le biais d'une référence à ce nom : DSW ne permet pas (encore) la création d'une liste déroulante qui listerait les contributeurs, il faudra donc renseigner ce nom manuellement. Il en découle que les contributeurs doivent être reférencés de manière consistante à travers le PGD, cela sera nécessaire lorsque le PGD sera lu/traité par des machines.
De même que pour les contributeurs, il est probable que le PGD décrive plusieurs produits de la recherche : les questions les concernant sont organisées d'une manière spécifique pour minimiser autant que faire se peut les doubles saisies. Au niveau supérieur de la hiérarchie, on retrouve deux questions, 'Les produits de la recherche' et 'Description des produits de la recherche'. Ces deux questions ont des objectifs différents.
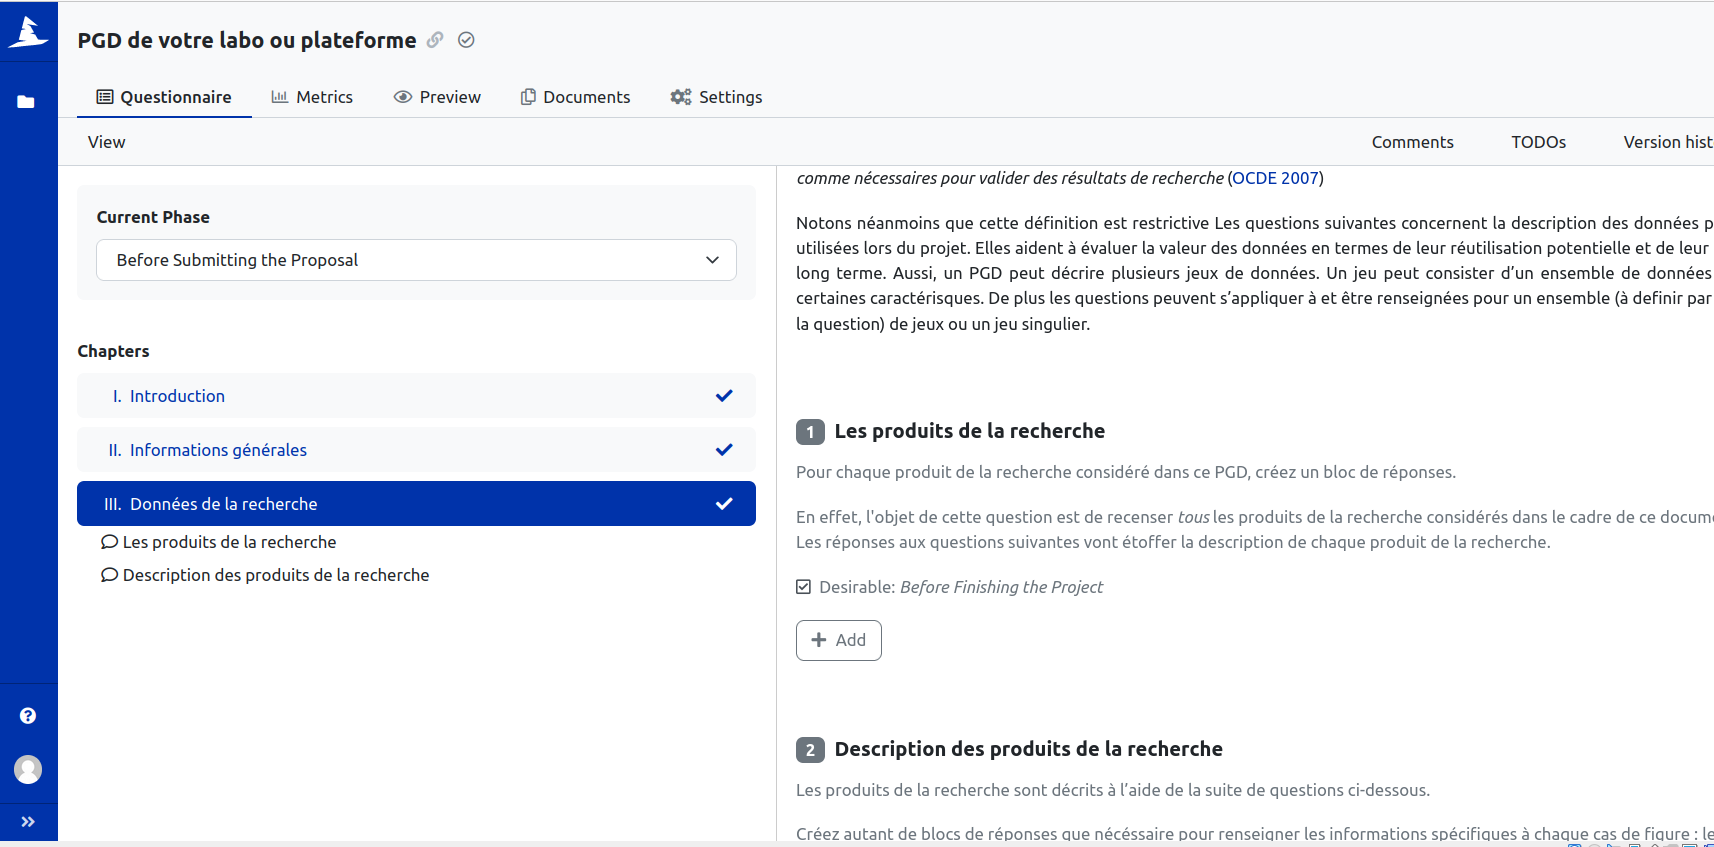
Une autre vue de cette même hiérarchie est donnée ici
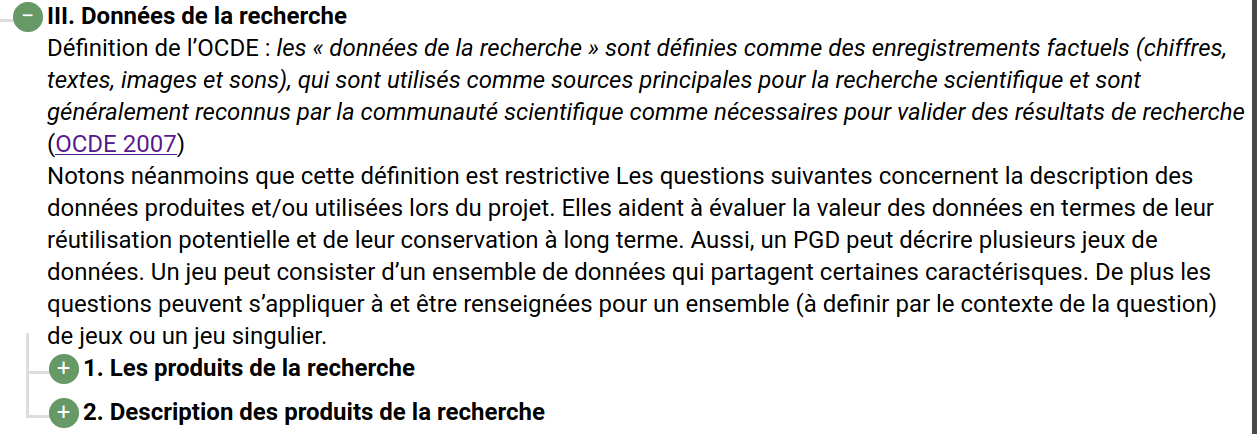
L'objectif de la question 'Les produits de la recherche' est uniquement de recenser tous les produits de la recherche : pour chacun d'entre eux il sera nécessaire d'ajouter un bloc de questions dont le but est de recueillir le nom/étiquette/label, l'identifiant (si déjà attribué/connu), et une description succinte. En particulier le nom/étiquette/label sera utilisé dans la suite du questionnaire pour associer les réponses aux produits de la recherche concernées par celles-ci (l'identifiant ne peut pas remplir ce rôle puisque tous les produits de la recherche n'ont pas nécéssairement d'identifiant, en particulier au début du projet).
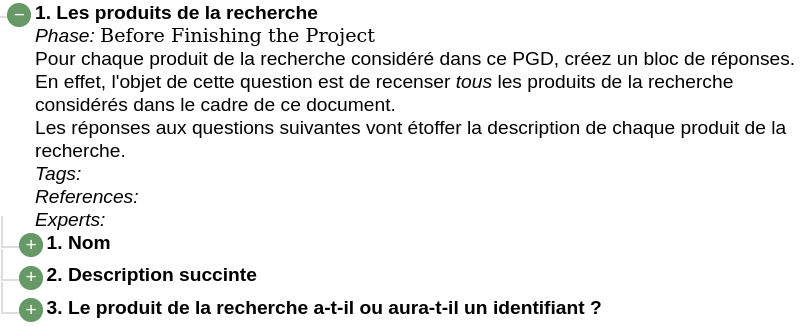
Pour cette question il suffit d'ajouter un seul bloc de questions :
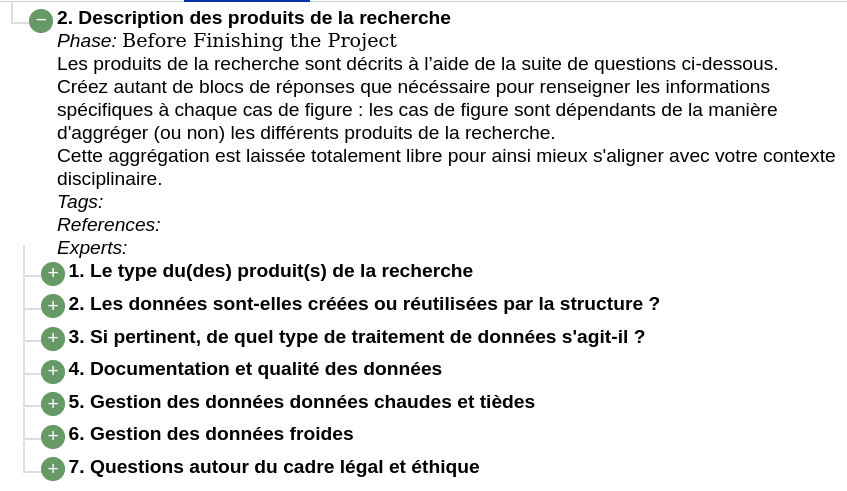
Ces questions (sept pour V1.4.15) vont guider la description détaillée des produits de la recherche listés plus haut. Chacune de ces questions se décline elle même comme un bloc de questions dont la première vous demandera de préciser quels produits de la recherche sont concernés par les réponses qui vont suivre :
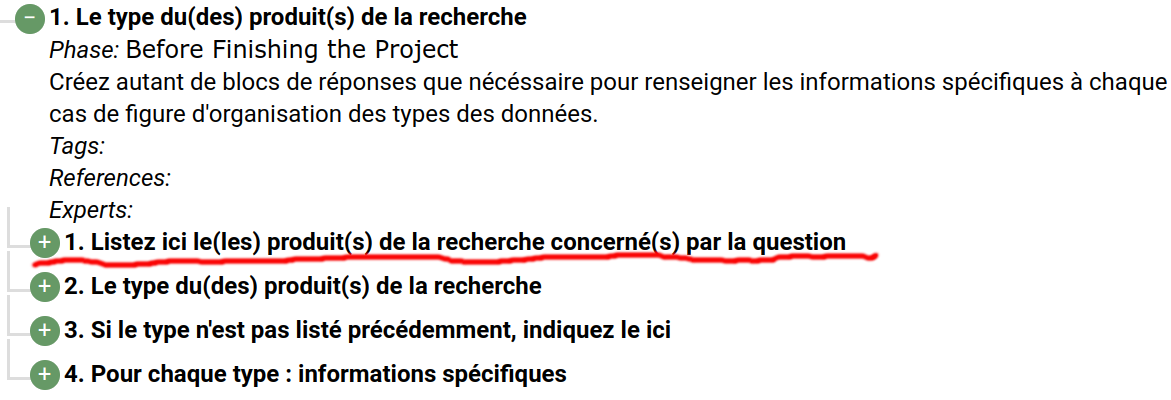
Cela implique deux choses :
-
Les produits de la recherche doivent être reférencés de manière consistante à travers le PGD, d'oú cette mention de nom/étiquette/label qui est va servir à identifier de manière unique le produit de la recherche. Cela sera nécessaire lorsque le PGD sera lu/traité par des machines. Ici aussi, le reférencement se fera manuellement, en attendant que DSW déploie une solution avec une fonctionalité 'listes déroulantes'.
-
Il faudra créer autant de blocs de réponses que nécessité par la diversité des réponses possibles : en d'autres termes, si tous les produits de la recherche se décrivent de la même manière, un seul bloc de réponses suffira et tous les produits de la recherche seront listés ici (en réalité, il suffira d'indiquer "tous" en lieu de la liste complète).
Comme déjà mentionné plus haut, cette manière de faire un peu lourde est rendue nécessaire car pour l'heure DSW ne permet pas la création de listes déroulantes.
Finalement, notons que pour les question deux et trois

la collecte de la liste des produits de la recherche associées aux réponses se décline un peu différement.
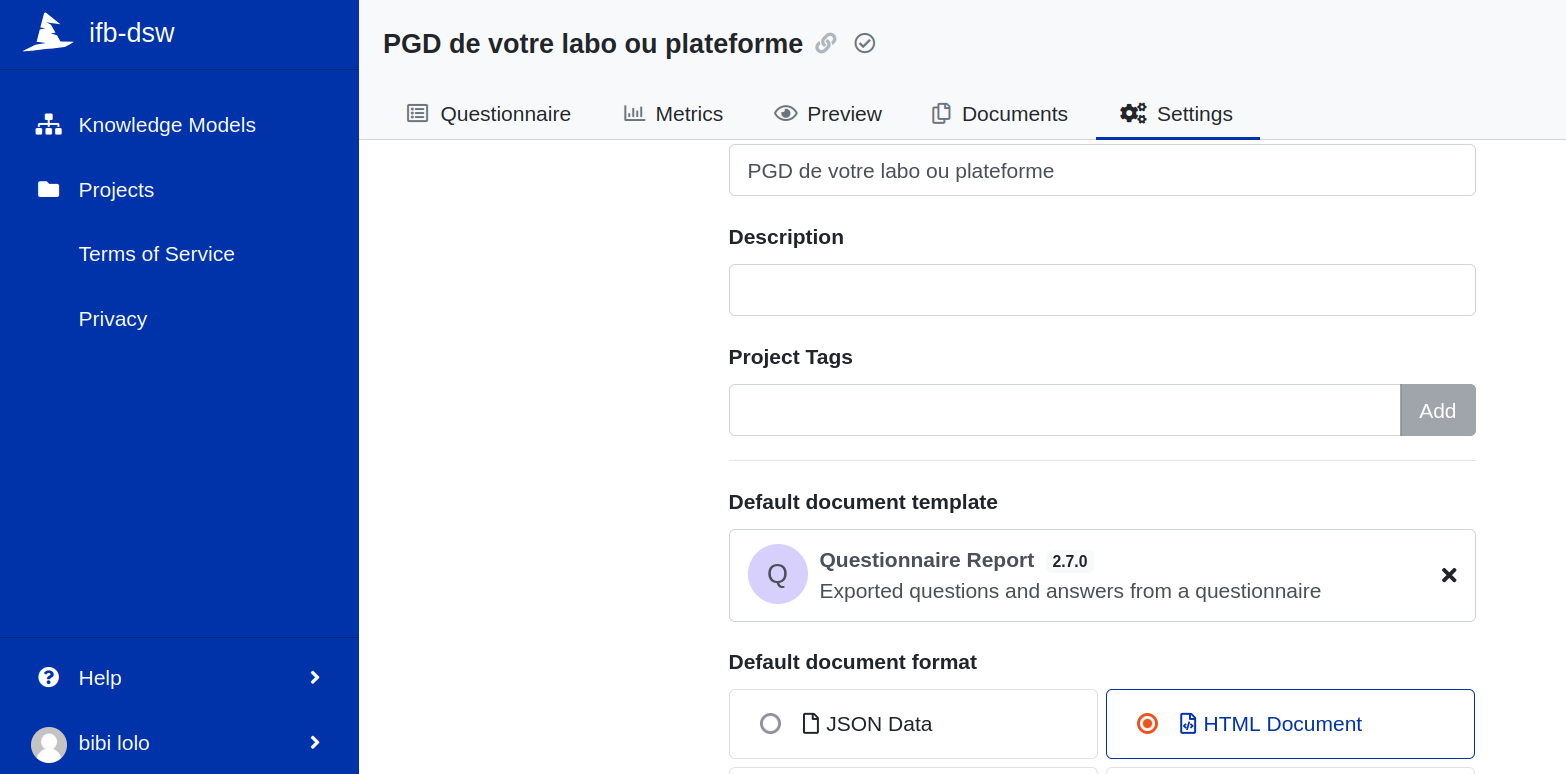
Lors du remplissage du questionnaire vous pouvez à tout moment choisir le format d’extraction, c'est à dire le « Output Template » ; ceci est nécéssaire si vous voulez soit pre-visualiser le questionnaire, soit en créer un document. Pour cela, il faut renseigner l'onglet "Settings" du questionnaire :
Le mieux est de choisir "Questionnaire Report", qui est d'ailleurs celui recommandé, et HTML comme format par défaut pour la prévisualisation :
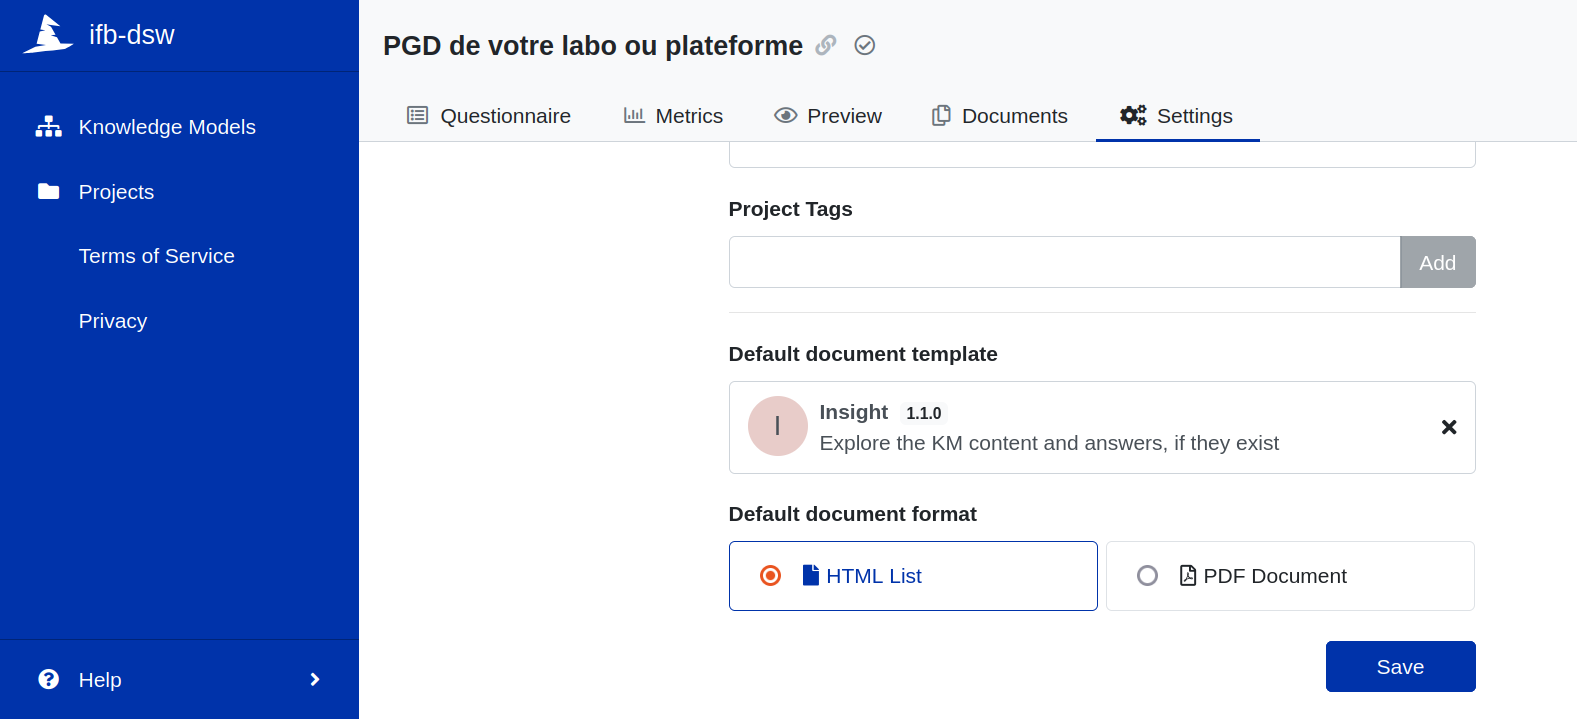
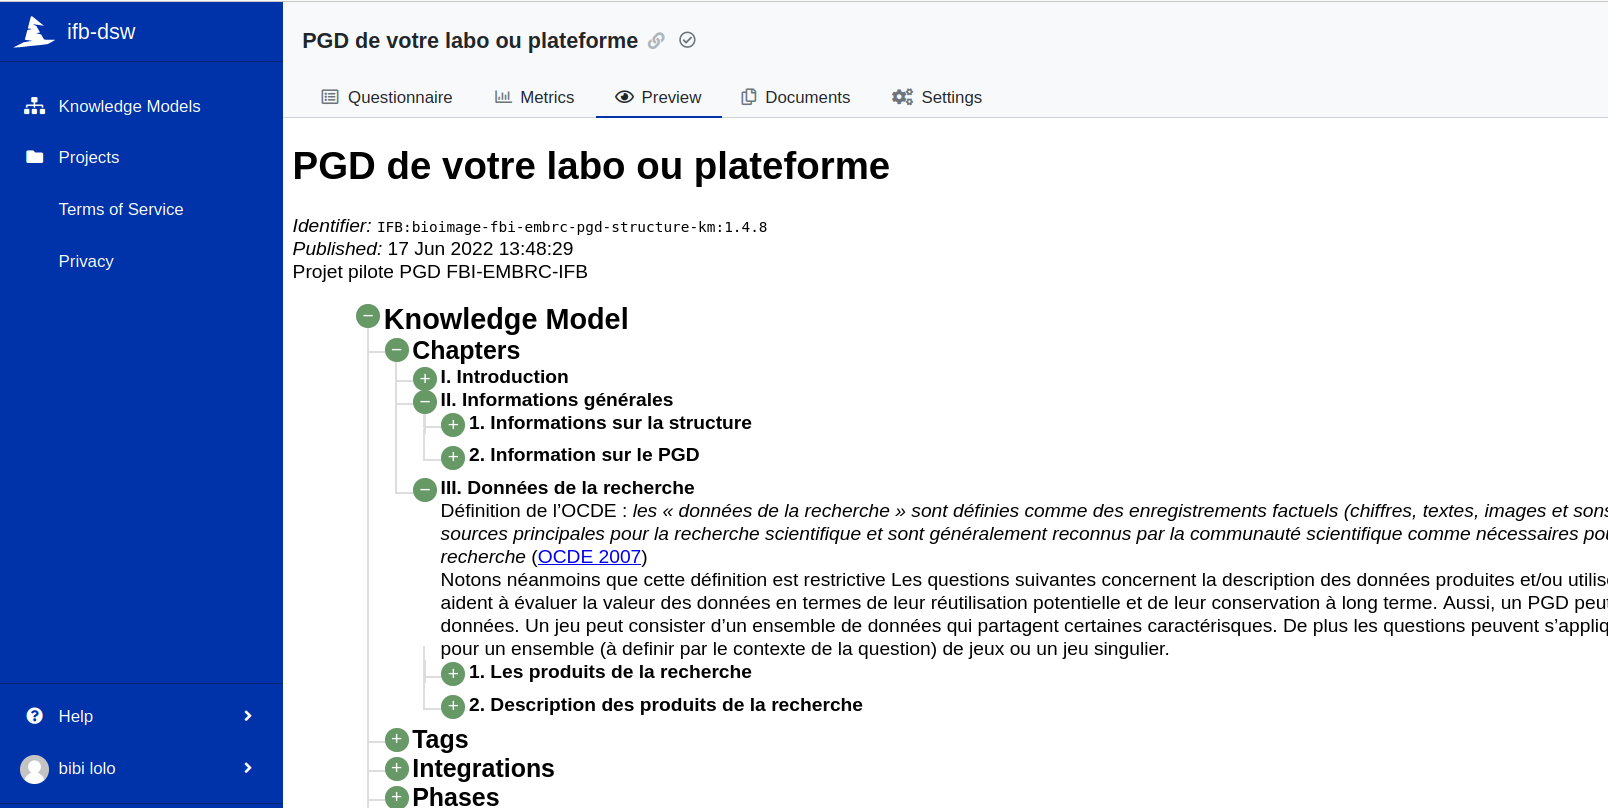
Un autre gabarit d'extraction qui peut se relever interessant, est 'Insight' qui vous permet de voir un déroulé complet de la hiérarchie des questions, avec les réponses si elles sont présentes :
Ce gabarit met en œuvre un semblant de 'dépliage/repliage' de la hierarchie des questions, cela n'est pas parfait (nous espérons l'améliorer dans les mois qui viennent) mais il peut permettre de palier à la difficulté de renseigner un PGD un peu long dans DSW. En voici un aperçu
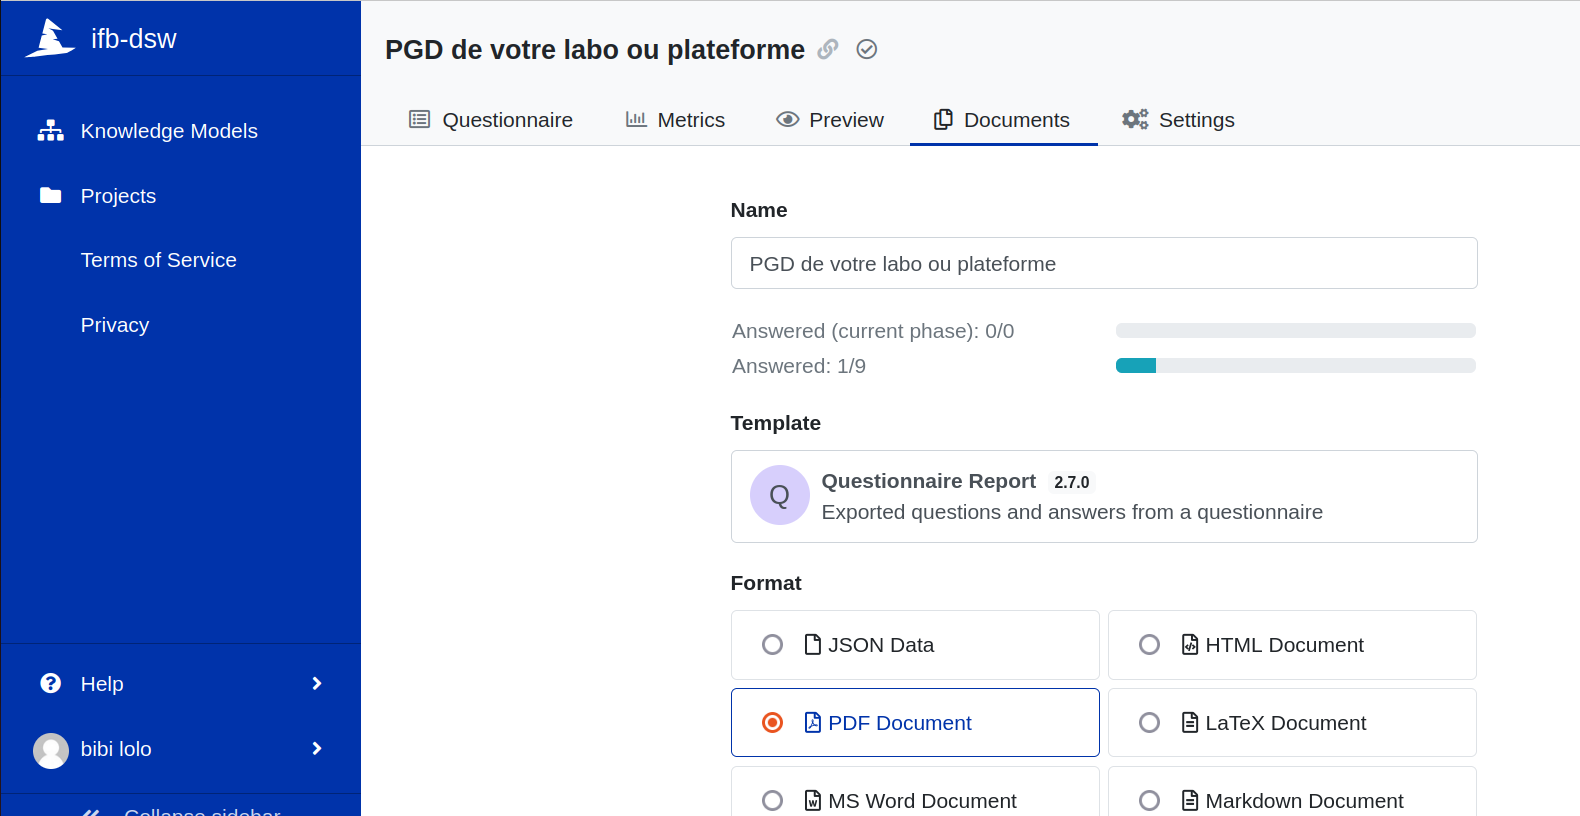
Choisir le menu  puis « Create ».
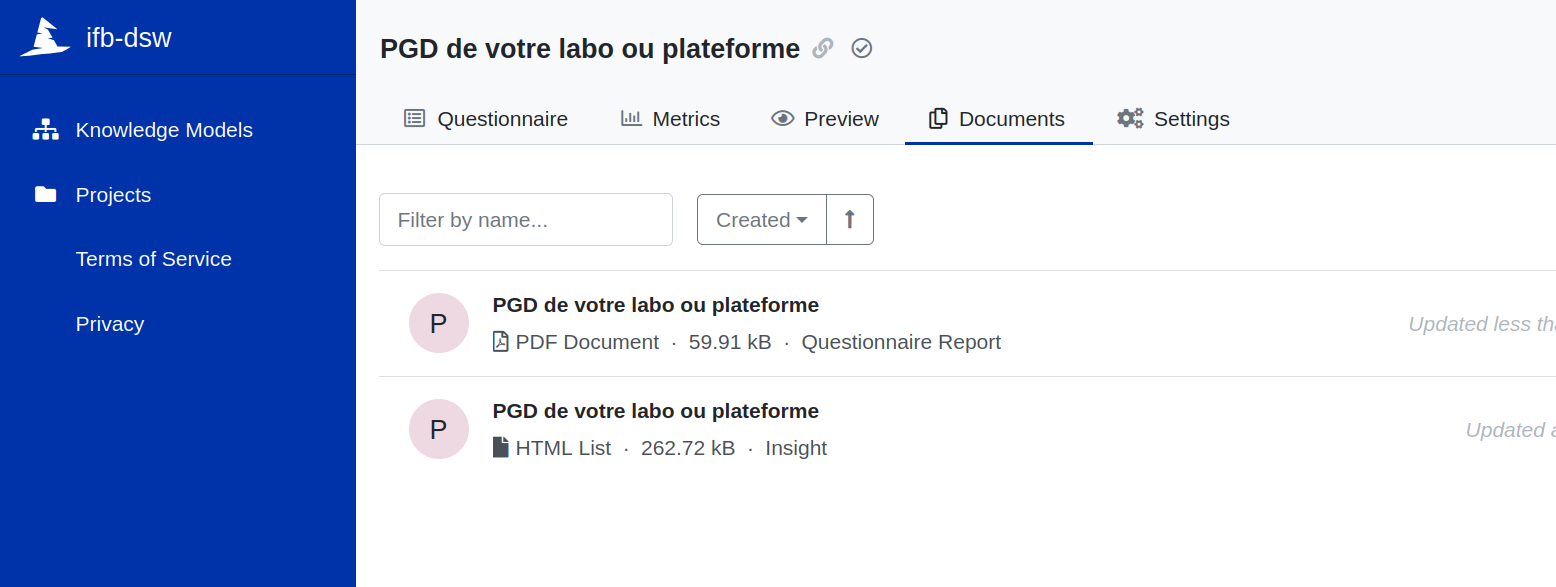
Votre document est maintenant disponible dans votre environnement « Projet » :
Choisir l'onglet PROJET, puis selectionner le projet que vous voulez partager. Pour accéder aux options du menu "SHARE", appuyez sur le bouton en haut à droite. 
Vous avez ensuite la possibilité de partager vos projets avec vos collègues, qu'ils disposent ou non d'un compte utilisateur DSW. Pour vos collègues ayant créé un compte, vous avez la possibilité d'inviter des personnes spécifiques et leur attribuer des droits cumulatifs, de lecteur à propriétaire.
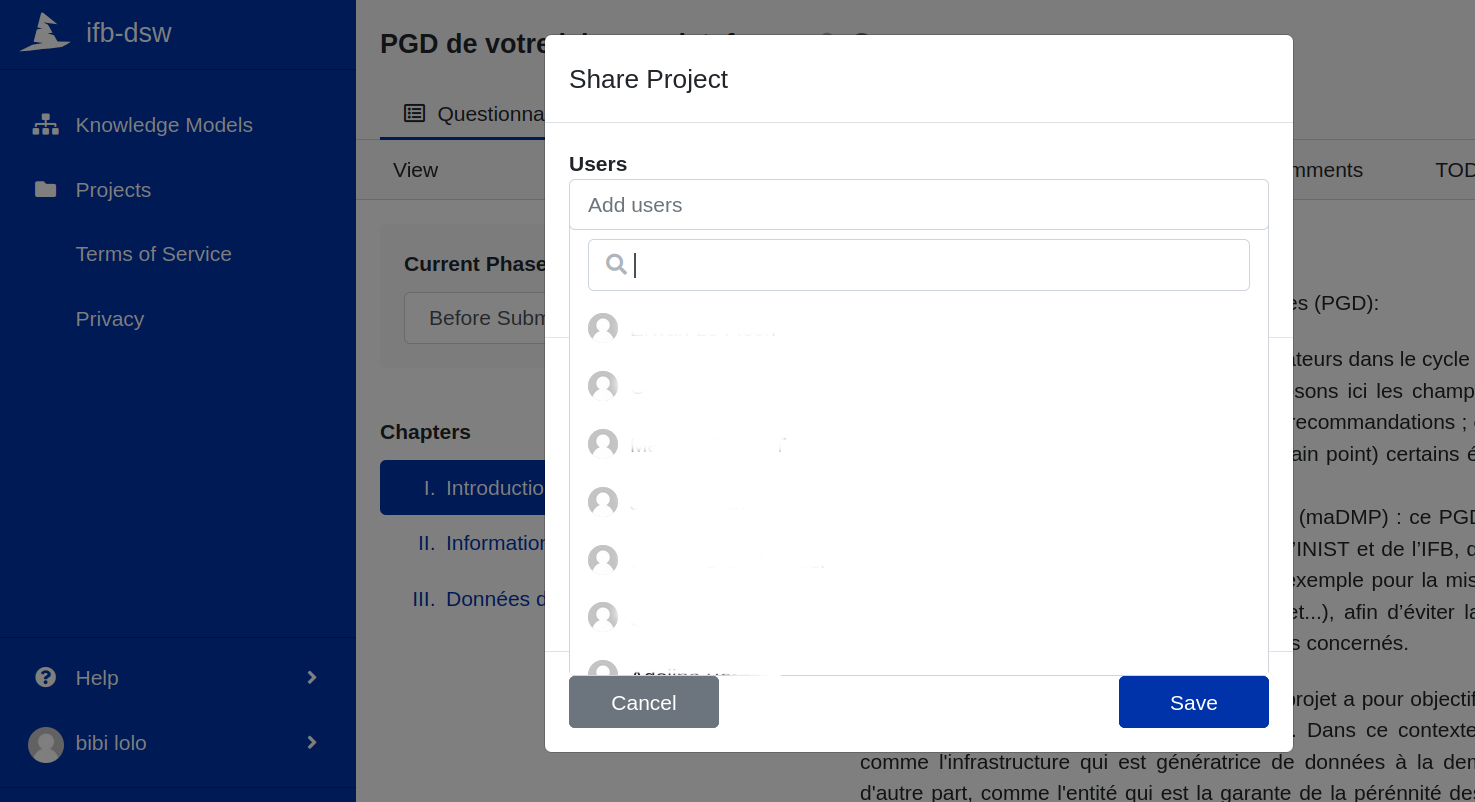
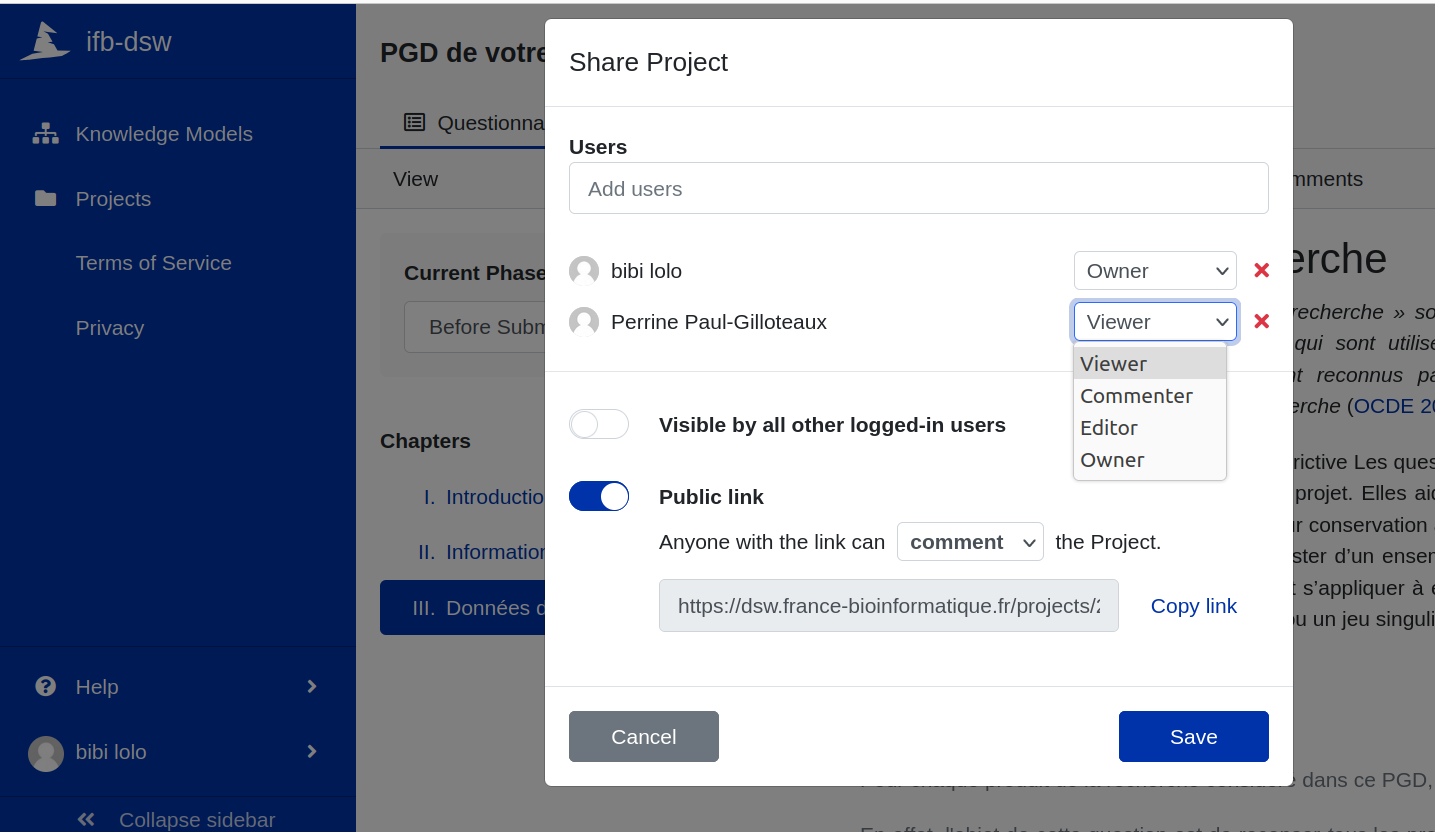
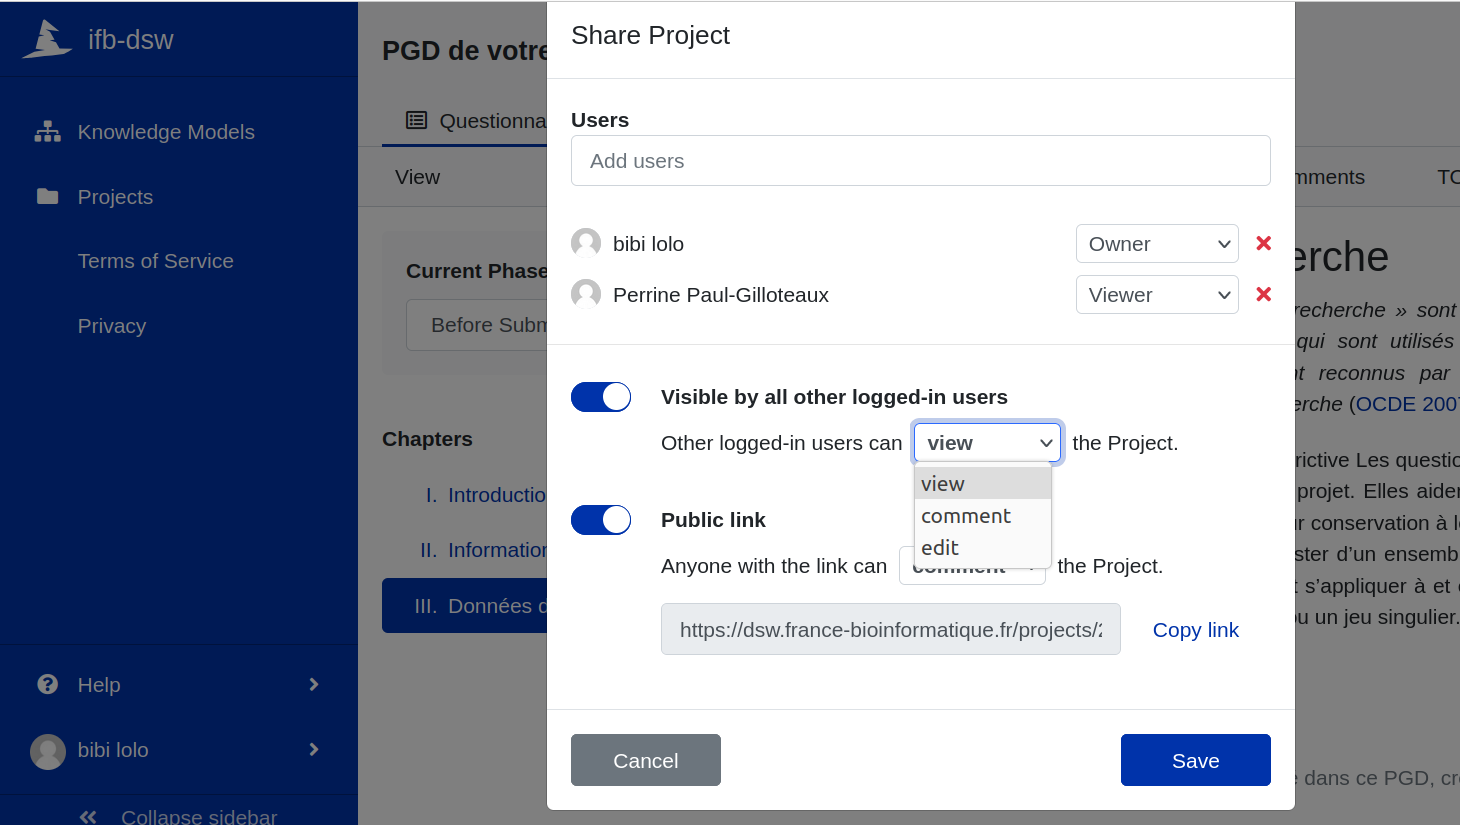
Ensuite, vous pouvez choisir de refuser ou d'ouvrir l' accès aux utilisateurs connectés à DSW et de leur attribuer certains droits
Enfin, vous pouvez rendre le lien unique de votre PGD (questionnaire) complété lisible par tout utilisateur non connecté : il faudra envoyer le lien du questionnaire à ces utilisateurs.
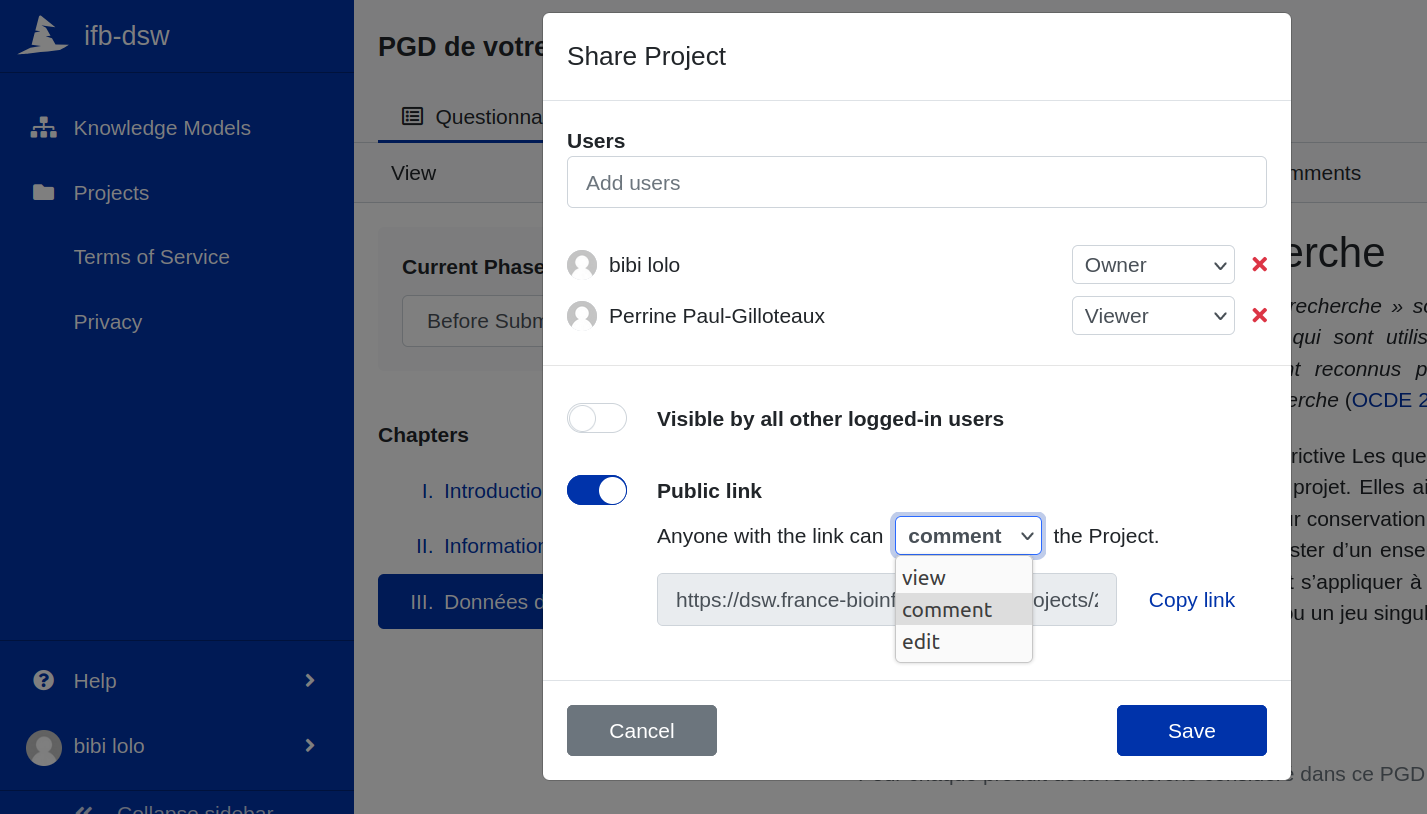
Notons plusieurs choses :
- le choix des droits à attribuer est aussi une fonction des paramètres globaux que les administrateurs choisissent au départ ; il se pourrait donc que ce choix soit plus restreint que celui démontré ici,
- vous êtes tenus de respecter les droits à la protection des données personnelles et donc il vous incombe de veiller à la manière dont vous partagez les projets,
- finalement, notez que le partage des documents issus du projet est soumis aux droits afférents au "Projet".
-
Quelle différence entre les PGDs Structure et les PGDs Projets ? Un PGD structure décrit la gestion des données pour une structure, suivant les types de données. Un PGD projet est associé à un projet scientifique, à un planning de réalisation, avec des dates. Le PGD structure va servir à remplir un PGD projet qui utilise des données produites par cette structure. Plus généralement, un PGD structure aide la structure à tracer ces données du moment de leur création à leur livraison aux donneurs d'ordre, les porteurs de projets donc.
-
Pourquoi ne pas utiliser [DMP OPIDoR] (https://dmp.opidor.fr) ? Nous utilisons dans le cadre de ce projet DSW pour ses fonctionnalités de travail collaboratif de conception de modèles de PGD, et sa visibilité et utilisation européenne. DMP OPIDoR présente lui l'avantage d'une interface beaucoup plus simple pour l'utilisateur qui renseigne le PGD. De plus DMP OPIDoR, depuis la version V3.0, présente un PGD structuré, partiellement machine-actionable (qui s'appuie sur des flux d'échange de données automatisés), et qui permet des spécialisations de certaines rubriques. Un recrutement est en cours pour developper des passerelles entre les deux outils ; notre but est à terme de déposer les modèles de PGD finalisés sur DMP OPIDoR.