2025년도 1학기 국민대학교 캡스톤디자인
AWS DeepRacer를 활용한 강화학습 기반 자율주행 프로젝트

Round 1 - Reinforcement Learning Time Trial 대표 주행 영상
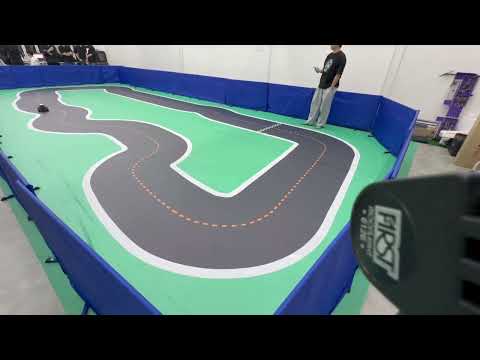
Round 1에서는 중심선 기반 보상에서 시작해 오프트랙 억제, 레이싱 라인 반영, 최종 3단계 보상 구조로 발전시키며 Time Trial 성능을 개선했습니다.
이 프로젝트는 AWS DeepRacer를 활용하여 강화학습 기반 자율주행 모델을 설계하고, 실제 대회 라운드에 맞추어 보상함수를 반복적으로 개선한 캡스톤 프로젝트입니다.
단순히 빠른 랩타임을 만드는 것에 그치지 않고,
- Time Trial 주행 성능 향상
- Object Avoidance 대응
- 랜덤/비공개 트랙 적응
- 시뮬레이션 모델의 실주행 검증
까지 포함하여 실험을 진행했습니다.
- Round 1: Time Trial용 강화학습 모델 개발
- Round 2: 장애물 회피(Object Avoidance) 모델 개발
- Round 3: 사전 학습되지 않은 트랙 및 비공개 트랙 대응
- 공통 목표: 보상함수 설계와 실트랙 검증을 통한 주행 안정성 확보
Round 1 / 2 / 3 대회 조건 보기
| 항목 | 내용 |
|---|---|
| Track | RL Speedway (95 % 축소) |
| 방향 | 반시계 |
| 알고리즘 | 강화학습 |
| 레이스 | Time Trial |
| 패널티 | 트랙 아웃 +2 s |
| 미션 | 3분 세션 × 2, 세션당 Timeout 1분, 가장 빠른 한 바퀴 기록 기준 |

| 항목 | 내용 |
|---|---|
| Track | RL Speedway (95 %) |
| 방향 | 반시계 |
| 알고리즘 | 자유 알고리즘 |
| 레이스 | Object Avoidance |
| 패널티 | 트랙 아웃 +2 s |
| 미션 | 3분 세션 × 2, 세션당 Timeout 1분 |

| 항목 | 내용 |
|---|---|
| Track | 대회 당일 공개 |
| 방향 | 반시계 |
| 알고리즘 | 강화학습 |
| 레이스 | Time Trial |
| 패널티 | 트랙 아웃 +2 s |
| 미션 | 3분 세션 × 2, 세션당 Timeout 1분 |

중심선 기반 보상에서 출발하여,
오프트랙 억제, 레이싱 라인 반영, 방향 정합성, 속도 유지 및 스무딩까지
점진적으로 보상함수를 개선했습니다.
- Model 1: 중심선 거리 + 속도 기반
- Model 2: 오프트랙 강패널티 적용
- Model 3: 레이싱 라인 기반 보상 실험
- Final Model: 거리 + heading + speed smoothing 기반 안정화
카메라 기반 주행에서 시작해 LiDAR 센서를 활용한 회피 전략까지 확장했습니다.
트랙 주행과 장애물 회피를 동시에 만족시키기 위해 단계별 학습 전략을 적용했습니다.
- Model 1: 충돌 감지 보상 추가
- Model 2: 카메라 + LiDAR 기반 확장
- Model 3: 단계적 학습 전략 적용
- Model 4: 통합형 회피 전략 최종 모델
특정 트랙에만 맞춘 모델이 아니라, 새로운 트랙에서도 안정적으로 주행할 수 있는 범용 모델과 특정 트랙을 위한 레이싱 라인 최적화 모델을 각각 설계했습니다.
- 범용 모델: RL Speedway 기반 일반화 검증
- A to Z Speedway: 레이싱 라인 기반 최적화
- Smile Speedway: 목표 랩타임 기반 추가 보상 설계
- Round 1에서 보상함수를 단계적으로 확장하며 속도와 안정성 사이의 균형을 찾는 과정을 수행
- Round 2에서 LiDAR 기반 회피 전략을 통합하여 완주율 100% 수준의 주행 달성
- Round 3에서 범용 모델과 특정 트랙 최적화 모델 모두 실험하여 일반화 성능과 최고 성능을 함께 비교
- 일부 모델은 실차 주행에서도 off-track 없이 안정적으로 주행 가능함을 확인
루트 README에는 대표 영상으로 Round 1을 배치했고, 각 라운드별 영상은 아래 링크로 확인할 수 있습니다.
보상함수 전체 코드보다,
왜 해당 보상함수를 설계했는지와 어떤 문제를 해결하려 했는지를 정리한 문서를 별도로 작성했습니다.
.
├── README.md
├── competition_overview.pdf
├── docs/
│   └── reward-design.md
├── assets/
│   ├── images/
│   └── videos/
├── round1/
│   ├── README.md
│   ├── model1.py
│   ├── model2.py
│   ├── model3.py
│   ├── final_model_step1.py
│   ├── final_model_step2.py
│   └── final_model_step3.py
├── round2/
│   ├── README.md
│   ├── model1.py
│   ├── model2.py
│   ├── model3.py
│   └── model4.py
└── round3/
    ├── README.md
    ├── model1
    ├── AtoZ_Speedway_CCW.py
    ├── Smile_Speedway_CCW.py
    └── RL_Speedway_CCW